Тестовый Kubernetes-кластер на VPS кажется быстрым способом приблизить разработку к production. Это действительно полезно, если цель сформулирована честно: проверить манифесты, сетевые зависимости, обновление и наблюдаемость. Но маленький кластер не становится копией большой инфраструктуры только потому, что в нём есть знакомые названия компонентов.
Тестовый Kubernetes-кластер — изолированная среда для проверки конфигурации и поведения приложений; он помогает обнаружить ошибки интеграции, но не доказывает производительность или отказоустойчивость production без сопоставимого сценария.
С чего начинается честный тест
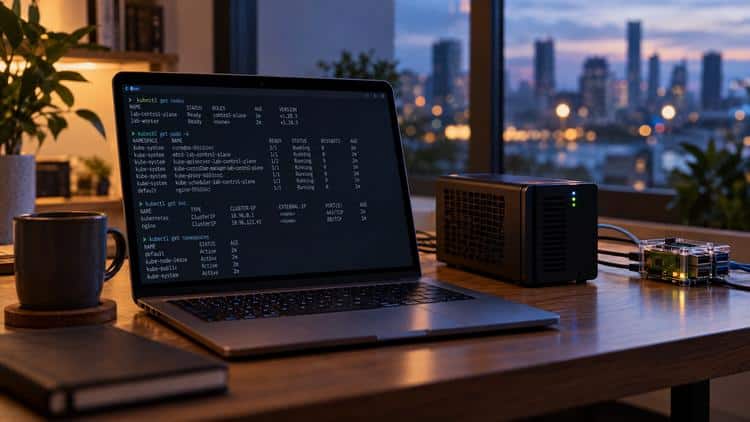
Сначала назовите вопрос, на который должен ответить кластер. Разработчик может проверять Helm chart и обновление образа, команда платформы — политики доступа и маршрутизацию, а владелец сервиса — восстановление после неудачного релиза. Это разные задачи; одна компактная VPS-схема не обязана одинаково хорошо доказывать каждую из них.
Миф: один узел показывает всё
Один узел удобен для обучения и проверки манифестов, но он не воспроизводит распределённые отказоустойчивые control plane и workload-узлы. Компоненты Kubernetes имеют разные роли, а планировщик и контроллеры зависят от доступности API. Поэтому успех на одном узле — это полезный сигнал совместимости, а не сертификат готовности к любой аварии.
Предупреждение: не переносите секреты, персональные данные или production-токены в учебный кластер «для удобства». Тестовая среда должна иметь собственные ограниченные учётные данные.
Миф: достаточно поставить Kubernetes и ресурсы появятся сами
Kubernetes умеет учитывать requests и limits контейнеров, однако эти поля не создают память и CPU на VPS. Если суммарные ожидания подов превышают доступный ресурс, часть задач не запустится или узел начнёт испытывать давление. Наблюдайте за состоянием узла, событиями планировщика, диском образов и журналами, а не только за статусом одного deployment.
- Отделите системные компоненты от тестируемого приложения.
- Задайте requests и limits как проверяемые предположения, а не декоративные поля.
- Проверьте, что происходит при перезапуске узла и недоступности образа.
- Соберите логи и события в месте, которое команда реально умеет читать.
Миф: тестовый кластер обязан быть мини-production
Иногда полезнее выбрать альтернативу: kind или k3d на машине разработчика для быстрых манифестов, managed-песочницу для проверки облачных интеграций, отдельный VPS-кластер для сетевых и операционных упражнений. Сравнивайте не бренды инструментов, а вопрос теста, стоимость сопровождения и риск ложной уверенности.
| Цель | Подход | Ограничение |
| Проверить YAML и образ | Локальный кластер | Сеть и диск отличаются от VPS. |
| Проверить маршруты и доступ | Небольшой кластер на VPS | Не моделирует многозонный production. |
| Проверить нагрузку | Отдельный воспроизводимый стенд | Нужны сценарий и измерения. |
| Обучить команду | Песочница с ограниченными правами | Нельзя переносить production-секреты. |
Три условные ситуации
Условная команда продукта хочет убедиться, что новый сервис получает конфигурацию и проходит health check. Для неё полезен небольшой кластер, который можно быстро пересоздать из кода. Условный интернет-магазин тестирует ingress, TLS и правила доступа перед сменой релиза. Ему важнее изоляция секретов и порядок отката, чем сходство названия VPS с production. Условная команда данных хочет проверить batch-задачу. Ей нужно различать проблему Kubernetes и нехватку места под образы, временные файлы или результаты вычислений.
Проверка, которая переживает понедельник
Самая неприятная иллюзия возникает, когда демонстрация прошла в пятницу, а в понедельник никто не знает, как попасть в кластер, где логи и кто обновил сертификат. Немного сарказма здесь заслуженно: кластер без владельца — это не платформа, а дорогая заставка в терминале.
- Зафиксируйте назначение кластера и запретные данные.
- Опишите доступы, удаление пользователя и путь экстренного входа.
- Проверьте восстановление конфигурации на чистой VPS.
- Сымитируйте неудачный релиз и выполните откат.
- Назначьте дату пересмотра, если стенд начинает использоваться шире.
Тестовый Kubernetes ценен тем, что делает предположения видимыми; он бесполезен, когда его выдают за доказательство свойств, которые не тестировались.
Где продолжить проверку
Версии компонентов следует фиксировать вместе с причиной обновления. Перед изменением проверьте совместимость манифестов, сохраните возможность отката и запишите наблюдаемый результат. Такой журнал превращает обучение в повторяемую работу.
Сеть требует отдельного внимания: DNS внутри кластера, ingress, firewall VPS и внешний DNS находятся на разных уровнях. Не объясняйте любую ошибку словом «Kubernetes» — сначала локализуйте, на каком участке исчез запрос.
Хранилище для теста тоже имеет границы. Временный volume может быть достаточен для демонстрации, но не для сценария восстановления. Различие нужно описать до того, как кто-то начнёт считать данные постоянными.
Мониторинг не обязан быть огромной платформой, однако у кластера должны быть понятные признаки жизни: состояние узла, события, ошибки приложений, занятость диска и способ оповестить владельца.
Если учебный стенд становится общим ресурсом, пересмотрите его права. Отдельные учётные записи и отзыв доступов обычно полезнее общего kubeconfig, который годами лежит в чате.
Карта зависимостей должна описывать не только VPS. Укажите DNS, сертификаты, внешние API, фоновые задания, хранилище и людей, имеющих право менять конфигурацию. Сервер может отвечать на запрос, когда одна из этих зависимостей уже перестала работать, поэтому диагностика начинается со всего пути запроса.
Контроль изменений не обязан быть бюрократией. Запишите ожидаемый результат, изменённую настройку, наблюдение, подтверждающее успех, и точку отката. Тогда следующему дежурному не придётся восстанавливать замысел по обрывкам команд в чате.
Безопасность лучше работает в конкретных действиях: отдельных учётных записях, минимальных правах, отзыве старого доступа и проверенном порядке обновлений. Широкое разрешение, выданное в спешке, на практике редко остаётся временным.
Тестовая среда должна воспроизводить поведение без копирования чувствительных данных. Она полезна для проверки старта, конфигурации, последовательности релиза и типичных сбоев. Результат такого теста нужно описывать честно: это доказательство для конкретного сценария, а не универсальный бенчмарк.
Расходы стоит рассматривать вместе с операционной работой. Меньший VPS может быть разумным, если сервис наблюдаем и восстанавливаем; дополнительный ресурс оправдан, когда он защищает известный пик или обслуживание. Записанная причина выбора поможет при следующем пересмотре.
Оповещение должно подсказывать первую безопасную проверку. Сигнал о диске обязан назвать том и путь диагностики, а сигнал о доступности — владельца и журналы. Сообщение, которое только пугает, команда быстро учится игнорировать.
Инвентаризацию для будущей миграции лучше сделать заранее. Перечислите домены, сертификаты, секреты, данные, задания по расписанию, firewall и внешние callback. Даже без переноса этот список показывает зависимости, которые стоит контролировать уже сейчас.
Заметка об инциденте должна стать материалом для дизайна. Зафиксируйте сигнал, ошибочное предположение, безопасное действие и постоянное исправление. Со временем эта короткая запись улучшает инструкцию надёжнее, чем общее обещание быть внимательнее.
Проверка доступов должна охватывать автоматизацию так же, как людей. Забытый ключ деплоя или webhook может оставаться полезным злоумышленнику после изменения проекта. У каждой учётной пары должны быть назначение, владелец и способ отзыва.
Полезно различать наблюдение и интерпретацию. Событие планировщика, предупреждение о памяти или ошибка сети являются сигналами, но вывод о причине требует проверки контекста. Такая дисциплина уменьшает число рискованных исправлений, сделанных по первому впечатлению.
Заранее определите срок жизни тестового кластера и правила удаления ресурсов. Временные образы, тома, DNS-записи и ключи накапливаются незаметно, а затем осложняют и оплату, и расследование. Удаление по чек-листу является частью безопасного эксперимента.
Проверяйте сценарии обновления отдельно от сценариев первого запуска. Чистая установка часто проходит легко, а изменение версии показывает несовместимость API, порядок миграций и реальные зависимости приложения. Для обучения этот разрыв особенно ценен.
Если команда использует CI для применения манифестов, ограничьте права этого процесса только нужным пространством имён и действиями. Автоматизация не должна получать больше доступа только потому, что это ускоряет первую демонстрацию.
Полезный тест оставляет после себя артефакты: версию конфигурации, краткий результат, замеченные ограничения и следующий вопрос. Без такой фиксации тот же эксперимент повторяют заново, но уже с другой памятью о деталях.
Не измеряйте успех только числом запущенных подов. Успехом может быть и вовремя найденная граница: например, что один узел не позволяет проверить требуемый failover или что диска не хватает для набора образов. Честное ограничение экономит больше времени, чем красивый статус.
При передаче стенда другой команде сначала пересмотрите секреты, роли и внешние маршруты. Описание в README полезно, но оно не отзывает доступ автоматически. Операционная передача должна включать и технический, и правовой контур ответственности.
Периодически сверяйте исходную цель с фактическим использованием. Если лаборатория стала местом постоянных интеграций, ей нужны иные правила обслуживания, чем одноразовому упражнению.
После определения цели теста имеет смысл изучить варианты VPS для лабораторного кластера на DeltaHost и соотнести их с памятью, диском и планом доступа вашей команды.
Вывод
VPS подходит для тестового Kubernetes-кластера, когда вы знаете, чему именно он должен научить команду. Ограничьте данные, измеряйте ресурсы, выбирайте альтернативы по задаче и репетируйте пересоздание. Тогда стенд даёт практическую уверенность без мифа о полном совпадении с production.